Цель на квартал обычно понятна. Поднять активацию, снизить отток, увеличить долю платящих. Но стоит произнести её вслух, и команда за минуту перепрыгивает к решениям: новый онбординг, скидка, кампания как у конкурента. Вопрос «почему это сработает» остаётся без ответа.
Идеи при этом бывают хорошими. Беда в том, что они появляются слишком рано. Команда пропускает слой, от которого всё зависит: чьё поведение должно измениться, чтобы цель сдвинулась.
Возьмём активацию. Из того, что её надо поднять, ещё не следует, что пора переделывать онбординг. Может быть, пользователь слишком поздно встречает ценность продукта. Может быть, нужный шаг в продукте есть, но его не находят. А может быть, дело вообще в трафике.
Последний вариант легко недооценить. В разборе Семёна Сафронова «Регистрации врут» есть наглядная пара каналов. Тот, что приводил к регистрации 38% посетителей, через неделю сохранял в продукте лишь 1,8% из них, а канал с 16% регистраций дал лучшее недельное удержание, 7,2%. Никакой онбординг не исправит канал, который приводит не тех людей.
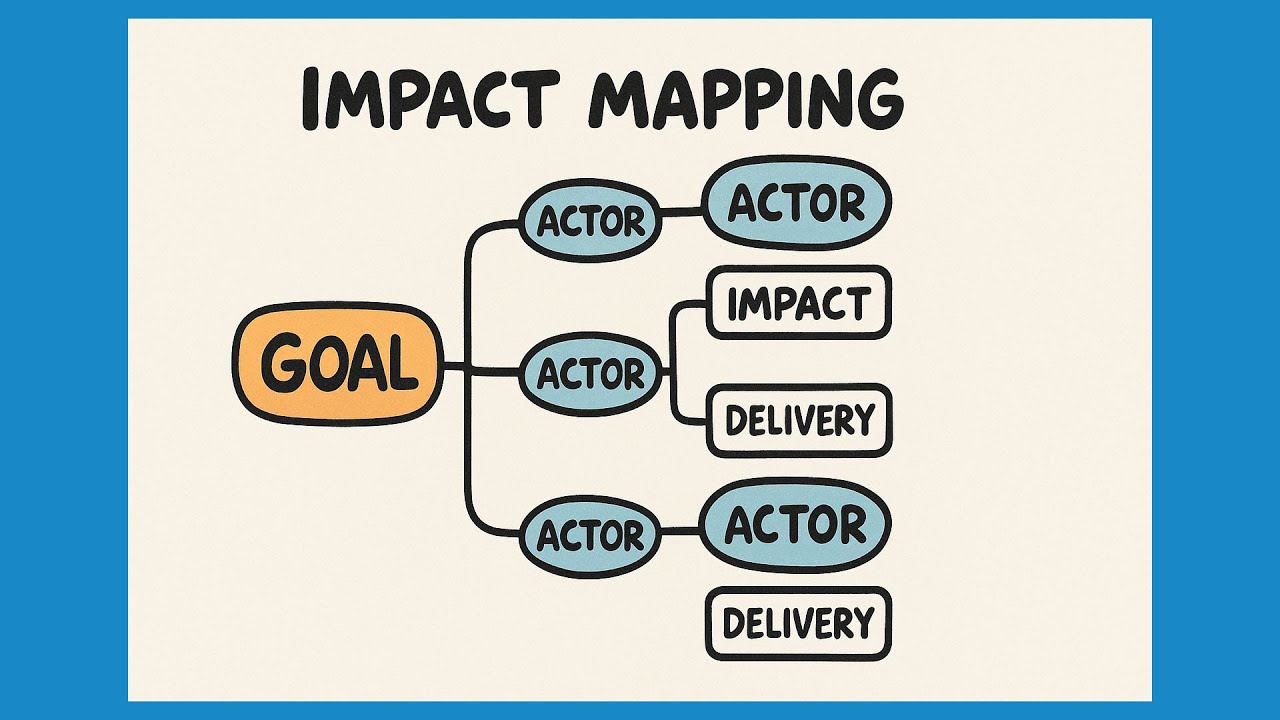
Impact Mapping останавливает этот прыжок к фичам. Метод простой, без бюрократии: он помогает связать бизнес-цель, поведение людей и конкретные инициативы в одну причинно-следственную цепочку. Карта отвечает на четыре вопроса. Чего мы хотим добиться? Кто влияет на результат? Какое поведение этих людей должно измениться? Что мы сделаем, чтобы оно изменилось?
Спор о приоритетах на деле оказывается спором о скрытых гипотезах
Типичное планирование выглядит так. Есть цель или давление сверху: показать рост, ответить конкуренту, отреагировать на тревожный график. Начинается обсуждение инициатив, и у каждого свой угол зрения. Продукт думает о фичах, маркетинг о спецпредложениях, дизайн о неудобствах в сценарии, продажи о барьерах в воронке, разработка о стоимости.
Все говорят об одном результате. Но представления о том, что должно измениться, у всех разные.
Здесь и возникает управленческая иллюзия. Кажется, что команда спорит о приоритетах. На самом деле она спорит о причинно-следственных гипотезах, просто не называет их. Один уверен, что выручку даст новая функция. Другой видит проблему в активации, третий в удержании, четвёртый в сообщении, которое приходит не вовремя.
Пока гипотезы не разложены явно, спор превращается в борьбу опыта и статуса. Выигрывает самый громкий или самый старший участник. Лучшая логика побеждает редко, и то случайно. Спор, где у каждого своя гипотеза, аргументами не выиграть. Его можно только проверить.
Impact Mapping вытаскивает эту логику на поверхность. Предложить инициативу теперь мало: её надо связать с изменением поведения и с целью. Меняется сам разговор. Вместо «давайте сделаем новую фичу» звучит «какое поведение она изменит». Вместо «надо дать скидку» звучит «какую группу это сдвинет и почему мы думаем, что дело в цене».
Особенно это нужно продуктовым командам. Они почти всегда работают с неполной информацией. Пользователь не рассказывает всей правды о своём поведении, аналитика не отвечает на вопросы сама, а одну проблему разные отделы видят через разные метрики. В такой среде легко начать управлять активностью. Её хотя бы видно: фичу выпустили, письмо отправили, баннер повесили.
Но выручку кнопкой не увеличить. Сначала меняется поведение группы пользователей: новички быстрее доходят до ключевого действия или платящие чаще пользуются главной функцией. Только потом, если это поведение связано с бизнес-целью, двигается метрика верхнего уровня.
Узнаваемый симптом: в компании много инициатив, много давления, бэклог растёт, роадмап пухнет, а влияние на цели остаётся туманным. Это роадмап желаний. Impact Mapping не даёт прятать его за активностью. Если на вопрос «какое изменение поведения мы покупаем этой инициативой» ответа нет, перед нами пожелание, оформленное под стратегию.
Четыре вопроса в строгом порядке: зачем, кто, как, что
Impact Mapping рисует карту логики между целью и действиями. Списка задач и плана реализации на ней нет. В центре цель. От неё идут группы людей, которые могут на неё повлиять. От каждой группы идут изменения поведения, которые сдвинут цель. И только в самом низу то, что команда может сделать в продукте, коммуникации или процессе.
В английской традиции это четыре вопроса: Why, Who, How, What. Why задаёт цель, Who называет акторов, How описывает impact, то есть изменение поведения актора, What перечисляет deliverables: фичи, кампании, процессы.
Смысл в порядке. Начнёте с What, и команда снова убежит в решения. Пройдёте последовательно через Why, Who и How, и список инициатив станет результатом выбора.
Каждая связь на карте остаётся предположением. Мы предполагаем, что deliverable вызовет impact, а impact приблизит цель. Магии между фичей и результатом нет. Есть только цепочка гипотез, которую потом придется проверять. Хорошая карта поэтому читается как набор ставок с логикой. План того, что точно сработает, она не обещает.
Физически карта помещается на одной доске: цель, две-три группы акторов, под каждой два-три impact, под ними варианты решений. Если на доске тесно, цель сформулирована слишком широко. Её стоит сузить до одного сегмента или одного этапа воронки.
Goal: цель
Лозунг из презентации целью не считается. Цель на карте должна проверяться: «поднять активацию новых пользователей с 6% до 8% за восемь недель» или «снизить отток платящих клиентов на два процентных пункта за квартал». Формулировки «стать удобнее» и «улучшить продукт» делают абстрактной всю карту.
Actors: акторы
Акторами называют группы людей, чьё поведение реально влияет на цель. Не только пользователи. Это могут быть новые и платящие клиенты, клиенты на грани оттока, администраторы в B2B-продукте, партнёры, поддержка, отдел продаж. Главное требование: актора можно найти в данных или процессах. Если сегмент нельзя выделить в аналитике, нельзя и проверить, изменилось ли его поведение.
Impacts: изменения поведения
Центральный и самый недооценённый слой. Impact описывает изменение поведения или состояния актора. Фича в этот слой не попадает. Например: «новички быстрее доходят до ключевого действия (critical event)», «админы приглашают больше коллег», «пользователи раньше понимают, зачем им продукт». Пропустите этот слой, и карта выродится в список идей.
Хороший impact проходит четыре проверки:
- Его можно наблюдать в данных как событие или долю, без опроса.
- Он принадлежит одному актору, а не «всем пользователям».
- Он может сдвинуться за срок цели. Если на изменение нужен год, а цель квартальная, ветка не подходит.
- В нём нет глагола команды. «Добавить», «сделать», «запустить» выдают решение.
Deliverables: решения
Решения появляются в самом конце: фичи, изменения в сценарии, спецпредложения, контент, интеграции. Влюбляться в первое решение здесь опасно. Сначала понятно, какой impact нужен, потом под него ищут несколько вариантов. Трёх-четырёх на один impact обычно хватает: дальше начинается мозговой штурм, а выбор не становится лучше.
Роадмап, OKR и story mapping отвечают на другие вопросы
Impact Mapping часто путают с привычными инструментами планирования. Отсюда разочарование: от карты ждут, что она заменит всё остальное, а получают схему, которая не говорит, что и когда делать. У неё просто другая роль.
Роадмап отвечает на вопрос «что и когда». Он синхронизирует команды, сроки и зависимости. Но почему именно эти инициативы сработают, роадмап не объясняет. Слабую логику он лишь красиво упакует. Карта нужна до роадмапа: она отсеивает инициативы, у которых нет права попасть в план.
OKR задают цели и измеримые ключевые результаты. Но между ключевым результатом и реальной работой остаётся пробел: через какое изменение поведения он сдвинется? Карта закрывает этот разрыв.
Допустим, ключевой результат звучит как «поднять долю команд, активных каждую неделю, с 40% до 45%». OKR фиксирует цифру и срок. Карта добавляет, чьё поведение должно измениться: администраторов, которые настраивают пространство, или участников, которые в него заходят. От ответа зависит, чем заниматься: настройкой прав доступа или уведомлениями о новых материалах.
User story mapping работает на уровне детализации пути пользователя: собрать MVP, разложить сценарий, расставить истории. Но какой сценарий стоит улучшать сейчас, он не говорит. Это решает карта влияния.
Ближе всего к Impact Mapping дерево возможностей, привычное командам с непрерывным discovery. Оба метода ставят цель наверх и спускаются к решениям через промежуточный слой. Разница в этом слое. В дереве это возможности, то есть потребности и боли клиента, найденные в интервью. В Impact Mapping это поведение конкретных акторов, включая внутренних. Если у команды поток интервью, дерево возможностей естественнее. Если цель зависит от нескольких групп людей, включая продажи и партнёров, удобнее карта влияния.
Правильнее видеть эти инструменты как слои одной системы. Impact Mapping отвечает за логику влияния, OKR за формализацию целей, роадмап за план во времени, story mapping за детали реализации.
Карта строится за четыре шага, и третий самый трудный
Первый вопрос после знакомства с методом практический: как это делать руками? Логика, которая обычно работает, укладывается в четыре шага.
Шаг первый: сформулируйте цель как проверяемый результат
Начинать нужно с цели, даже если фича или боль команды кажутся очевиднее. Хорошая цель ограничена сроком, привязана к сегменту и выражена метрикой. Слишком общая цель превращает карту в дерево всех возможных инициатив.
Перед картой стоит проверить базовую цифру. Шесть процентов активации посчитаны за какой период и на каком трафике? Если от недели к неделе показатель сам по себе гуляет между 5% и 7%, цель в 8% почти неотличима от шума, и её стоит сформулировать через средний уровень за четыре недели.
Часто удобно привязывать goal к North Star или к одному из ключевых входов в North Star. Ленни Рачицки, разбирая North Star метрики 40 с лишним компаний, приводит пример Miro, где главной метрикой считают число досок, созданных для совместной работы. Цель карты для такой компании звучала бы как вход в эту метрику, например доля новых команд, создавших вторую доску за неделю. Даже без формальной North Star правило то же: цель описывает результат, и активность на её место не годится.
Шаг второй: определите акторов
Следующий вопрос: кто реально влияет на цель. Первая ошибка возникает здесь: акторов пишут слишком общими или слишком много. Начните с одного-двух. Для активации это могут быть новички в мобильном приложении и на компьютере, потому что контекст у них разный. Для расширения использования это администраторы, которые приглашают команду. Для оттока это платящие клиенты, которые заходят всё реже.
Критерий простой: актора можно отследить в данных и увидеть, изменилось ли его поведение.
Шаг третий: сформулируйте impacts
Самый трудный и самый ценный шаг. Здесь нужно удержаться и не соскочить в фичи. «Упростить онбординг» уже решение. Impact звучит иначе: «новые пользователи чаще доходят до первого ценностного действия в первую сессию». «Сделать письма красивее» тоже. Impact: «пользователи, не дошедшие до critical event, возвращаются и завершают его в течение суток».
Лучше всего формулировать impacts через продуктовые события: первый проект, первое приглашение коллеги, первая повторная сессия, первое использование ключевой функции. Тогда карта описывает реальное поведение, и каждый impact сразу получает метрику.
Шаг четвёртый: подберите deliverables
Только теперь обсуждают решения. На одну ветку обычно приходится несколько вариантов, и это хорошо. Один эффект можно вызвать подсказкой, шаблоном, письмом, реферальной механикой, помощью поддержки или изменением сценария. Единственно верный вариант угадывать не нужно. Нужно увидеть спектр ставок и выбрать самый дешёвый тест.
Все четыре шага укладываются в одну встречу на 90 минут. Пять-семь участников: продукт, аналитика, маркетинг или CRM, дизайн, кто-то из поддержки или продаж. Примерный тайминг: 10 минут на формулировку цели, 15 на акторов, 30 на impacts, 20 на решения и 15 на ранжирование веток. Самый длинный блок отдан impacts намеренно: именно там команда чаще всего срывается в фичи, и ведущему приходится возвращать разговор к поведению.
Карта, которую продакт-менеджер (PM) нарисовал в одиночку и принёс на согласование, работает хуже. Остальные видят в ней чужие гипотезы и защищают свои. Ценность метода во многом в том, что спор о причинах происходит один раз, при всех и до того, как кто-то начал писать код.
Активация с 6% до 8% за восемь недель
Проще всего увидеть логику на сквозном примере; цифры в этом и следующем примере придуманы. Команде нужно поднять активацию на седьмой день у новых пользователей из платного трафика с 6% до 8% за восемь недель. Обычным путём она сразу начала бы спорить о новом онбординге, оффере и текстах.
Карта заставляет идти иначе. Цель зафиксирована. Акторы: новички в мобильном приложении и новички на компьютере. Impacts: пользователи чаще доходят до critical event в первую сессию, время до активации сокращается, ценность продукта становится понятна раньше. Только потом deliverables: меньше шагов, шаблон сразу после регистрации, контекстные подсказки, письмо тем, кто не дошёл до critical event.
Карта подсказывает и третьего актора, о котором на продуктовом планировании обычно забывают: команду, которая закупает трафик. Если каналы различаются по удержанию так же сильно, как в примере Сафронова, impact для неё звучит как «доля бюджета в каналах с лучшим недельным удержанием растёт». Решение здесь лежит в настройках рекламных кабинетов, вне продукта, и проверяется за пару недель.
В текстовом виде, чтобы перенести в документ планирования, карта выглядит так:
- Цель: активация на 7-й день у новых пользователей из платного трафика 6% → 8% за 8 недель
- Актор: новички в мобильном приложении
- Impact: доходят до critical event в первую сессию (метрика: доля, %)
- Deliverable: шаблон сразу после регистрации
- Deliverable: 3 шага вместо 5
- Impact: не дошедшие возвращаются в течение суток (метрика: доля вернувшихся и завершивших)
- Deliverable: письмо через 2 часа после первой сессии
- Impact: доходят до critical event в первую сессию (метрика: доля, %)
- Актор: новички на компьютере
- Impact: раньше видят ключевую ценность (метрика: медианное время до активации)
- Deliverable: демо-проект с данными вместо пустого экрана
- Impact: раньше видят ключевую ценность (метрика: медианное время до активации)
- Актор: новички в мобильном приложении
Дальше ветки сравнивают по стоимости проверки. И тут работает простая арифметика. Допустим, из платного трафика приходит 5 000 новичков в неделю. Чтобы надёжно заметить рост активации с 6% до 7% в A/B-тесте, нужно примерно 9 500 пользователей в каждой группе при стандартном уровне значимости 5% и мощности 80%:
n на группу ≈ 2 × (1,96 + 0,84)² × p × (1-p) / d² = 15,68 × 0,065 × 0,935 / 0,0001 ≈ 9 500
Тест 50 на 50 потребует около 19 000 пользователей, почти четыре недели трафика. За восемь недель команда успеет проверить две такие ставки подряд, а на десять таких ставок трафика уже не хватит.
Это и есть главный практический вывод карты. Шаблон после регистрации и сокращение шагов бьют в один impact, их можно объединить в один вариант. Письмо относится к другому impact и требует своей метрики, но его можно проверить параллельно на тех, кто не дошёл до critical event. Спор о том, «нужен ли новый онбординг», сменяется вопросом, какая ветка проверяется дешевле.
Второй пример показывает, что акторы бывают не только пользователями. B2B-сервис хочет снизить месячный отток платящих аккаунтов с 3% до 2% за квартал. У сервиса 1 000 аккаунтов со средним чеком 200 долларов в месяц. Один процентный пункт оттока означает 10 аккаунтов и 2 000 долларов регулярной выручки каждый месяц. За квартал сохранённые аккаунты накапливаются: 30 аккаунтов и 6 000 долларов ежемесячной выручки к концу периода.
Акторов здесь трое. Администратор аккаунта решает, продлевать ли подписку. Рядовые сотрудники клиента пользуются продуктом каждый день, и от их активности зависит, увидит ли администратор ценность. Третий актор внутренний: аккаунт-менеджеры сервиса.
Impacts у каждого свои. Администраторы чаще открывают отчёт об использовании перед продлением. Рядовые пользователи подключают вторую интеграцию в первый месяц. Аккаунт-менеджеры связываются с клиентом, у которого активность упала на треть, в течение недели, ещё до письма об отмене.
Под последним impact лежат совсем не продуктовые решения: сигнал о падении активности в CRM, правило очерёдности звонков, скрипт разговора. Без карты такие ветки обычно не попадают в продуктовое планирование вовсе, хотя могут оказаться самыми дешёвыми.
Каждая связь на карте остаётся ставкой, и большинство ставок проигрывает
Многие команды рисуют карту один раз на воркшопе, радуются её логичности и забывают. Чтобы этого не случилось, карту связывают с метриками, экспериментами и приоритизацией.
Скепсис к собственным ставкам здесь оправдан. Продукт, который уже работает, оставляет мало места для лёгких побед: очевидные улучшения сделаны, и большинство новых идей либо ничего не меняют, либо делают хуже. Если на карте шесть веток, разумно ожидать, что сработают одна-две.
Обратная ловушка: ветка, которая сработала подозрительно хорошо. Рост активации на четыре пункта от одной подсказки сначала проверяют на сбой в разметке событий и только потом празднуют.
Отсюда три правила. Первое: у каждого impact есть метрика. Если impact звучит как «новые пользователи быстрее доходят до critical event», нужны доля активированных и время до активации. Для «админы чаще приглашают коллег» нужны число приглашений и доля админов, которые их отправляют.
Второе: deliverables проверяют минимальным способом. Прототип, запуск на небольшую часть пользователей, ручной эксперимент, «нарисованная дверь» (кнопка функции, которой ещё нет), тест коммуникации. Превращать каждую ветку сразу в большой эпик не нужно.
Третье: ветки ранжируют. Impacts неравноценны, deliverables неодинаково реалистичны, гипотезы неодинаково правдоподобны. Подойдёт ICE, RICE (её придумали в Intercom) или своя система оценки. Суть одна: карта нужна для жёсткого выбора.
У метрик impact есть и своя ловушка: команда быстро учится двигать сам показатель, не меняя поведения, ради которого его выбрали. Если impact звучит как «админы чаще приглашают коллег», команда быстро научится увеличивать число приглашений, например рассылая их всем контактам из адресной книги. Поэтому к метрике impact добавляют ограничитель. Для приглашений это доля принятых приглашений: если она падает, рост числа отправленных ничего не значит.
После каждого теста карту обновляют. Ветку, где impact сдвинулся, а цель нет, помечают отдельно: значит, ошибочна связь impact с целью, и остальные решения под этим impact можно не проверять. Ветку, где решение не сдвинуло impact, закрывают только для этого решения. У карты должен быть один владелец, обычно PM, который вносит результаты после каждого теста. Раз в две недели такой пересмотр занимает 20-30 минут и экономит недели работы над ветками, которые уже опровергнуты.
Метод приживается, когда входит в регулярные процессы. Самый естественный вариант: карта как пролог к квартальному планированию. Сначала уточняют желаемый результат, потом строят карту, выбирают сильные ветки и только после этого превращают их в эпики и план.
Второй вариант: карта как фильтр. Новую срочную идею от руководителя или заказчика прогоняют через те же четыре вопроса. Какую цель она двигает, на какого актора влияет, какое поведение должно измениться, как мы это увидим? Если связи нет, идея не исчезает навсегда. Она просто перестаёт притворяться приоритетом.
Третий: карта как общий язык продукта, маркетинга и CRM. Активация зависит от качества трафика, от продукта и от первых писем одновременно. Карта позволяет трём функциям видеть одну логику вместо трёх параллельных.
Со временем появляется и отложенный эффект. Команда, которая фиксирует предположения и проверяет их, накапливает знание о том, какие рычаги реально двигают систему. Список сделанных фич такого знания не даёт.
Из-за чего карта перестаёт работать
Ошибки повторяются от команды к команде.
Самая ранняя: цель сформулирована как активность. «Выпустить новую систему рекомендаций» целью не является, это уже deliverable. С такой целью карта теряет смысл до начала работы.
Самая распространённая: решения подменяют impacts. В слое impact пишут «добавить подсказки», «сделать новый экран оплаты», «улучшить онбординг». Всё это решения. Impact описывает изменение поведения.
Третья: попытка охватить всё. Карта с десятками акторов и impacts перестаёт помогать думать. Лучше одна цель, пара акторов и два-три главных impact.
Четвёртая: предположения так и остаются непроверенными. Без гипотез, метрик и тестов карта остаётся логичной картинкой.
Пятая: акторы описаны как персонажи. «Маша, 32 года, маркетолог» хороша для дизайна, но в аналитике её не найти. Актор на карте должен совпадать с сегментом, который можно выгрузить.
Шестая: карту не пересматривают, когда меняется цель. Квартальная цель сменилась, а старые ветки продолжают пополнять бэклог. Новая цель требует новой карты, даже если акторы остались прежними.
У метода есть и честное ограничение. Он почти бесполезен там, где связь между действием и результатом уже известна и измерена. Если команда знает, что каждая секунда загрузки страницы оплаты стоит определённую долю конверсии, рисовать карту ради ускорения страницы незачем. Достаточно бэклога и метрики. Карта окупается там, где мнений о причинах больше, чем данных о них, и где на цель влияют несколько групп людей.
Решение можно посчитать. Воркшоп на 90 минут с шестью участниками стоит девять человеко-часов. Один эпик, который два разработчика три недели делают впустую, стоит около 240 часов. Если карта хотя бы раз в квартал отсекает такой эпик, она окупается в двадцать с лишним раз. Если команда из трёх человек работает над одним очевидным рычагом, отсекать нечего, и время лучше потратить на сам эксперимент.
Слой причинности между целью и роадмапом
Ценность метода мало зависит от самой диаграммы или воркшопа, где её нарисовали. Impact Mapping меняет порядок мышления. Между целью и инициативами появляется обязательный слой причинности. Роадмап, прошедший через этот слой, реже превращается в коллекцию активностей.
Проверить, нужен ли он вашей команде, можно на текущем бэклоге. Возьмите цель, которую уже обсуждаете, запишите её со сроком и сегментом и назовите одного-двух акторов с двумя-тремя impacts в виде продуктовых событий. Затем разложите под ними инициативы, которые уже лежат в бэклоге.
Те, что не легли ни под один impact, отложите в отдельный список. Отложить не значит выбросить: к ним возвращаются, когда появляется цель, которой они служат, и к тому моменту часть из них уже никому не нужна. Для оставшихся выберите самый дешёвый тест и метрику, по которой через две-три недели станет ясно, сработала ли ставка.
Если под impacts легло меньше половины бэклога, команда планировала по мнениям.