Две версии кнопки, неделя ожидания, победила зелёная, выкатываем на всех. И так по кругу. При таком подходе A/B-тесты быстро превращаются в дорогой способ подтверждать то, что команда и так собиралась сделать.
Тест отвечает только на вопрос, который задали до запуска
Ритуал выглядит рационально. Есть данные, есть победитель, решение будто бы принято само. Но если вопрос, на который отвечал тест, никто не сформулировал, цифры ничего не решают. Подтверждение готового решения стоит той же недели трафика, что и честная проверка, но к знанию ничего не добавляет.
Кнопки, цвета и тексты лишь материал. Сам A/B-тест служит инструментом проверки гипотез. Он начинается задолго до запуска и заканчивается тогда, когда по результату принято решение; значимость сама по себе ничего не закрывает. Именно здесь процесс ломается чаще всего.
Между бизнес-целью и изменением в продукте лежит цепочка из пяти звеньев: гипотеза, метрика, эксперимент, интерпретация, решение. Выпадает одно, и тест теряет смысл. Распад цепочки выдают три сигнала:
- команда крутит элементы интерфейса, не понимая, какую бизнес-проблему они решают;
- результаты не влияют на план разработки, потому что решения принимаются по другим причинам;
- за тесты отвечает один человек, а решения принимает другой, и результат некому превратить в действие.
Когда эксперименты не приносят пользы, причину обычно ищут в неудачных гипотезах. Удобное объяснение, но настоящая причина в другом. Чаще тестирование встроено так, что извлечь из него ценность нельзя в принципе: гипотезы рождаются хаотично, тесты запускают ради количества, а решение принято заранее.
Тест без победителя встречается чаще всего, и это нормально
Ожидать, что каждый тест найдёт победителя, наивно. В зрелых программах экспериментов победители в меньшинстве, а нейтральные и отрицательные исходы вместе встречаются гораздо чаще.
Считать тест без значимой разницы провалом поэтому странно. Отсутствие эффекта тоже результат. Правда, оно не доказывает, что гипотеза была слабой или что изменение не влияло на поведение: возможно, выборки просто не хватило.
Ошибиться в оценке ожидаемого эффекта тоже допустимо. Если команда понимает, почему ожидания не сбылись, следующие гипотезы становятся точнее. A/B-тесты ценны как способ учиться.
Значит ли низкий процент побед, что тестировать бессмысленно? Скорее наоборот: редкий крупный выигрыш, который никто не проверил, так и лежит в бэклоге с пометкой «неважно». Низкий процент побед лишь повод тестировать дешевле и честнее.
Проблема начинается, когда логику эксперимента раз за разом игнорируют. Гипотезы пишут постфактум. Значимый результат автоматически считают правильным, не разбирая влияния на бизнес. Неудобные данные не признают: результат не подтвердил ожидания, а команда всё равно идёт заранее выбранным путём. В этот момент команда уже не учится, а только делает вид.
Тест ломается на стыках с исследованием, релизом и командой
Первый стык с исследованием. A/B-тест ставят вперёд него и тестируют решения, не разобравшись в проблеме. Гипотеза звучит как «попробуем так», и в ней не сказано, почему это должно сработать. Рабочая логика обратная: тест проверяет гипотезу, которая выросла из интервью и анализа поведения. Тревожный симптом простой: команда не может объяснить, чему хочет научиться этим тестом.
Второй стык с релизом. Тест запущен, но результаты не успевают повлиять на выпуск, и команда либо игнорирует данные, либо ждёт их слишком долго. Работает другая схема: запуск, доработку или откат решают по критериям, записанным заранее. Если тесты постоянно «мешают» релизу, процесс спроектирован неверно. Длительность теста оценивают вместе с планом релиза: если он не успевает к дате, это видно ещё на планировании.
Третий стык с командой. Одни и те же данные читают по-разному, берут разные метрики и приходят к противоположным выводам. Работает это, только когда все говорят на одном языке: все понимают, какие метрики важны, какие эффекты значимы и какие решения возможны. Когда результат теста становится поводом для конфликта, логика нарушена.
Два документа до запуска: гипотеза и критерии решения
Хороший тест начинается с записанной логики решения. Настройка в аналитике лишь техническая часть. Ещё до старта понятно, зачем он проводится и какой выбор возможен по итогам. Для этого нужны два документа.
Первый: записанная гипотеза. В ней сказано, как изменение повлияет на действия пользователя, а через них на бизнес-метрику. Что именно изменится в поведении и почему. Изменение интерфейса в ней только средство.
Второй: критерии решения. Команда заранее договаривается, какой результат считать успехом, какой провалом, а какой нейтральным. Это защищает от подгонки выводов под желаемое.
Удобный шаблон помещается в одну фразу: «Если вариант B выиграет хотя бы X по метрике Y, мы сделаем Z; если нет, сделаем W». Например: «Если новый экран оплаты поднимет конверсию в покупку хотя бы на 1 п. п., раскатываем его на всех; если нет, возвращаемся к исследованию причин отказа». Цифры здесь условные, важна форма.
К двум документам полезно добавить защитную метрику. Это показатель, который не должен ухудшиться, даже если основной вырос: возвраты, обращения в поддержку, удержание на 30-й день. Тест, который поднял конверсию и уронил защитную метрику, не выигран.
Не получается заполнить пропуски в шаблоне, значит, тест пока не нужен. Сначала нужны гипотеза и решение, которое от неё зависит.
Ошибки управления случаются в основном до старта
Большая часть ошибок происходит ещё до запуска. Тест стартует без гипотезы, из любопытства. Или гипотезу подменяют идеей: формулируют изменение интерфейса, но не ожидаемый эффект и его механизм.
Дальше подводит выбор метрики. Часто измеряют то, что легко посчитать, хотя бизнесу важно другое. А без заранее оговорённых критериев команда не знает, что делать с результатом, каким бы он ни вышел.
Другая группа ошибок про то, как тест ведут и читают. Решение принимают только по статистике, без бизнес-контекста. Запускают настолько мелкие изменения, что заметного эффекта они дать не могут. Обрывают тест раньше срока, принимая шум за сигнал. Выводы не фиксируют и не переиспользуют, а метрикой успеха становится число экспериментов.
Тот же настрой слышно в дежурных репликах. «Давайте просто попробуем и посмотрим» стартует тест без вопроса. «Если статистически значимо, делаем» отрывает цифру от контекста. «Этот тест ничего не показал, забудем» выбрасывает знание, которое могло сузить гипотезы. «Метрику потом выберем» превращает эксперимент в имитацию ещё до запуска.
Сколько данных нужно, чтобы увидеть эффект
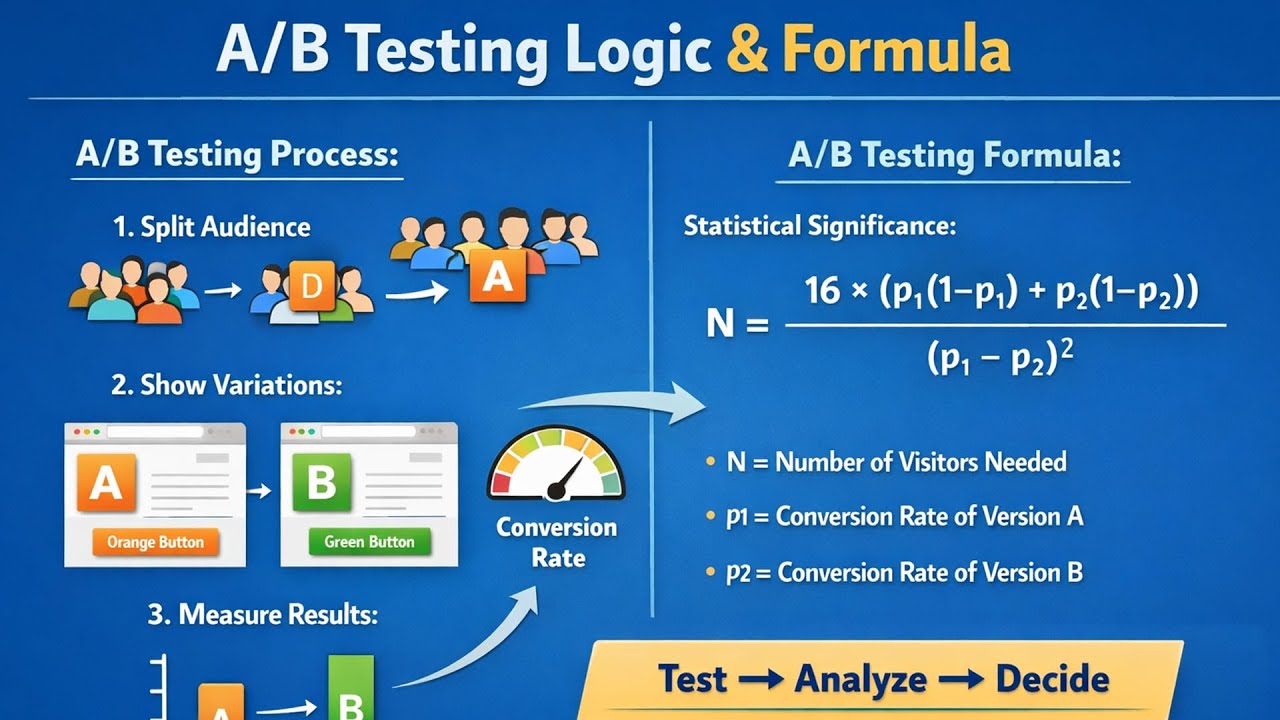
Две из этих ошибок, слишком мелкое изменение и преждевременная остановка, сводятся к одному. Данных не хватает, чтобы отличить сигнал от шума. Прикинуть нужный объём можно до запуска. Для сравнения двух конверсий грубая оценка выборки на каждый вариант выглядит так:
n ≈ 16 × p × (1-p) / δ²
Здесь p означает базовую конверсию, δ минимальный абсолютный прирост, который вы хотите надёжно поймать. Коэффициент 16 соответствует привычным настройкам: 5% риска увидеть эффект там, где его нет (α), и 80% шанса заметить эффект, если он есть (мощность).
Допустим, база p = 5% (0,05), и вы хотите заметить прирост в 1 процентный пункт (δ = 0,01):
n ≈ 16 × 0,05 × 0,95 / 0,01² = 16 × 0,0475 / 0,0001 ≈ 7 600 на вариант
Это около 15 200 наблюдений на тест ради одного пункта. При 1 000 посетителей страницы в день тест займёт около двух недель. При 300 в день почти два месяца. Отсюда видно, почему остановка «на третий день» показывает шум.
Если трафика мало, расширяют δ. При δ = 2 п. п. выборка падает вчетверо, до 1 900 на вариант. Цена в том, что эффекты меньше двух пунктов такой тест уже не заметит, и это нужно записать в критерии решения.
Подглядывание делает шум ещё громче. Если проверять результат каждый день и останавливать тест при первой значимости, доля ложных побед уходит далеко за номинальные 5%: случайные колебания рано или поздно пересекают порог. Защита скучная: объём выборки считают заранее и не останавливают тест до него. Если следить за тестом непрерывно действительно нужно, есть последовательные методы. Джохари, Пекелис и Уолш в 2015 году описали «всегда валидные» p-значения, с которыми тест можно остановить в любой момент без потери корректности.
Похожая ловушка с числом вариантов. Пять вариантов против контроля, каждый на уровне 5%, дают шанс хотя бы одного ложного победителя около 23%: единица минус 0,95 в пятой степени. Чем больше вариантов, тем строже порог для каждого.
Есть и обратная ловушка: данных вроде бы хватает, а результат слишком хорош. У аналитиков экспериментов на этот случай есть старое правило: цифра, которая выглядит необычно интересной, скорее всего, ошибочна. Прирост конверсии на 30% от смены цвета кнопки почти всегда означает сломанное разбиение, задвоенные события или ботов в одной из групп. Сломанное разбиение встречается чаще, чем кажется: в Microsoft примерно 6% A/B-тестов показывают рассогласование долей выборки (SRM), и платформа проверяет его критерием хи-квадрат с намеренно жёстким порогом p < 0,0005. Слишком хороший результат проверяют с той же строгостью, что и провал.
Когда тестируют косметику вместо гипотез
Два типичных сценария, и корень у них общий.
Представим команду интернет-магазина, которая тестировала активно: цвета кнопок, тексты баннеров, расположение блоков. Экспериментов становилось больше, выручка почти не двигалась. Формально тестирование кипело, а к продуктовым решениям не приводило. Результаты были нейтральными или давали минимальный эффект.
Команда пересобрала логику. Перед каждым тестом стали записывать гипотезу, привязанную к конкретному этапу воронки, и выбрали несколько метрик, которые влияют на выручку. Тесты стали крупнее и реже. Часть показала отсутствие эффекта, и это приняли как результат. Экспериментов стало меньше, решений лучше.
В SaaS-продукте тесты жили только на уровне интерфейса. Команда верила, что оптимизация UX сама поднимет конверсию и удержание. Прошли десятки тестов, ключевые метрики не сдвинулись. Продакт-менеджер списывал это на сложность продукта и длинный цикл покупки.
Разбор показал, что тесты не трогали точки, где пользователь принимает решение. Изменения были косметическими и на мотивацию не влияли. Подход пересмотрели: тесты стали проверять гипотезы о ценности, сообщениях и активации, а метрики собрали вокруг ключевого действия. Часть тестов дала отрицательный результат. Именно он помог отказаться от ошибочных идей. Отрицательный тест стоил пару недель трафика. Ошибочная фича, раскатанная на всех без теста, стоила бы кварталы поддержки.
Проверки перед запуском
Каждый пункт проверяется ответом «да» или «нет»:
- гипотеза записана вместе с ожидаемым эффектом и механизмом;
- решение по каждому исходу записано по шаблону «если X по Y, то Z, иначе W»;
- метрика отражает ценность для бизнеса, а не удобство подсчёта;
- критерии успеха зафиксированы до старта;
- объём выборки посчитан, и трафика хватает на него за разумный срок;
- изменение достаточно крупное, чтобы дать эффект нужного размера;
- дата остановки назначена заранее, промежуточные значения не используются для решения;
- нейтральные и отрицательные результаты попадают в общую базу выводов.
Несколько принципов помогают не сбиться. A/B-тест проверяет гипотезу в реальном поведении, поэтому он служит продолжением исследования. Нужен он не всегда: только когда решение действительно неопределённо. Если ответ очевиден, эксперимент лишь жжёт трафик и время.
Значимому результату можно доверять только вместе с правильно выбранными метриками. Значимый рост клика, который роняет выручку или удержание, остаётся плохим решением. А тест без эффекта тоже полезен: после него остаётся меньше вариантов, которые стоит проверять.
Маленькому продукту тесты тоже нужны, если у него есть трафик и реальная неопределённость. Без трафика честнее признать, что вопрос решается исследованием.
Работу с тестами измеряют качеством решений, которые по ним приняты. Число запусков в квартальном отчёте выглядит солидно, но зелёная кнопка из первого абзаца тоже когда-то была запуском, и чему она научила команду, не помнит никто.